摘要
摘要
發布日期:2026-09-15 本文撰寫日期:2026-09-18
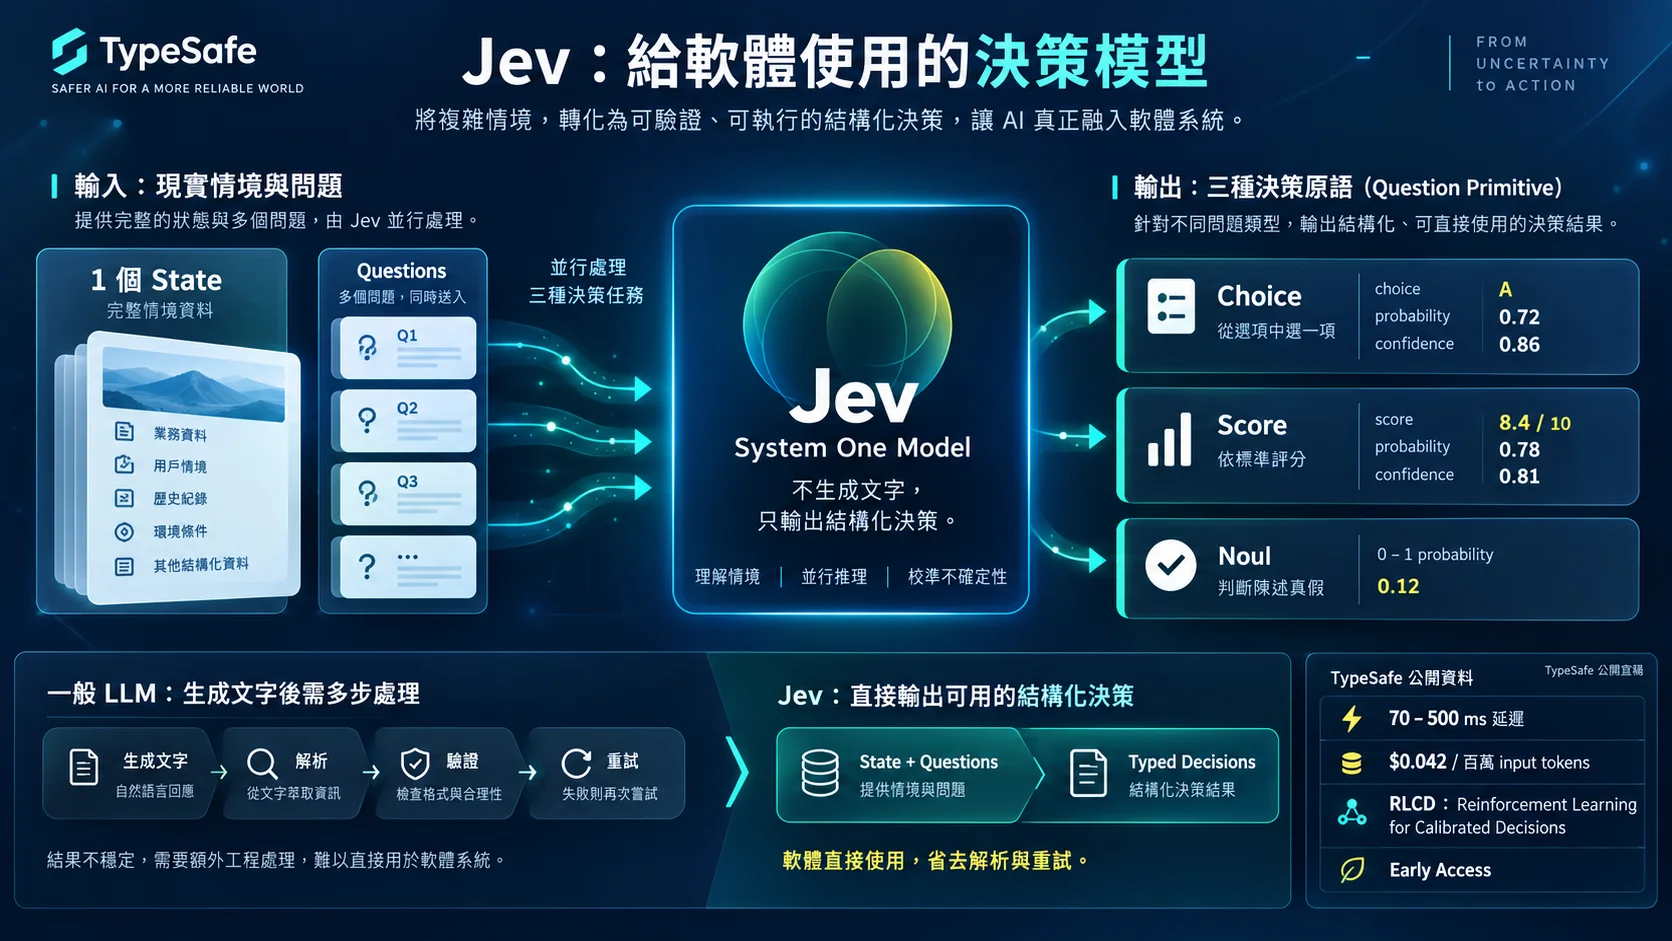
Jev 是新創 TypeSafe AI(創辦人 Diogo Almeida,前 OpenAI 研究員、InstructGPT 論文作者之一)發布的決策專用模型,官方稱為第一個公開的「System One Model」——不生成自然語言文字,一次呼叫接收 1 個情境(state)加任意數量的問題,直接回傳結構化決策(Choice/Score/Noul 三種原語,各帶機率與 confidence)。延遲 70–500ms,計費 $0.042/百萬 input tokens、output 免費,訓練方法為官方自訂的 RLCD(Reinforcement Learning for Calibrated Decisions),目標是讓機率輸出經過校準(confidence 真的反映實際對錯率),跟一般 LLM 用 RLHF/RLVR 訓練生成人類偏好文字的目標不同。同步宣布 4000 萬美元種子輪(DCVC 領投,估值約 2 億美元)。目前為 waitlist 制 early access,僅提供 hosted API,無開源權重、不可自行部署。若下文與此摘要衝突,以此摘要為準。
這篇文章不打算重複一般的「新產品介紹」——那類資訊各家科技媒體已經寫得夠多。真正值得花時間的地方是兩點:這個架構其實不是新發明(Anthropic 自己就公開講過同樣的模式),以及從資安角度看,這種「決策專用模型」站在 pipeline 中間是什麼意思。
Jev 到底是什麼
市面上絕大多數 LLM API 做的事情是「生成文字」:你送一段 prompt,模型逐 token 吐出回應,你的程式再去解析、驗證格式、必要時重試。Jev 反過來——它跳過生文字這一步,直接輸出型別化的結構化答案。
Choice
從候選清單中選一項,回傳 choice、每個選項的機率、confidence。
Score
依評分標準打分,回傳 score(可為小數)、機率、confidence。
Noul
判斷一句陳述是否為真,回傳 0–1 的機率值。
並行處理
單次呼叫可混合多個問題原語一起送出,一次拿到所有答案,不用分開呼叫。
下圖是 TypeSafe 官方發佈資料整理的輸入輸出示意(經查證核實,數字與名詞均與官方一手來源一致):
怎麼用:API 與程式碼範例
目前是白名單 early access:到 console.typesafe.ai/settings/keys 申請 API key(或透過 Vercel AI Gateway),安裝對應語言的 SDK,直接呼叫。
1. 安裝 SDK
- Python(3.10+):
pip install typesafe-sdk - JavaScript/TypeScript(Node 20+):
npm install @typesafe-ai/sdk
2. 呼叫 API
底層是 POST https://api.typesafe.ai/v1/systemone,model id 用 jev-latest(正式環境建議鎖版本號,如 jev-1.13.0,避免模型更新後結果漂移)。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state={
        "ticket": {
            "subject": "Duplicate charge",
            "messages": [{"from": "customer", "text": "I was charged twice..."}]
        }
    },
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems"
            }
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=["Calm", "Frustrated but civil", "Very angry"]
        ),
        "refund_requested": Noul(instructions="The customer is explicitly asking for a refund")
    }
)

print(response.answers["department"].choice, response.answers["department"].confidence)
這個呼叫一次拿到「該分派哪個部門」「客戶情緒分數」「是否明確要求退款」三個結構化答案,不需要另外寫程式解析文字回應。
技術限制
| 項目 | 限制 |
|---|---|
| State + Questions 總長 | 合計上限 64k tokens |
| 單一問題長度 | 最長 32k tokens |
| 速率限制 | 每秒 25 萬 tokens、每分鐘 1,200 次請求(超過回 429) |
這個架構不是新發明——Anthropic 自己就講過
Jev 主打的「用小快模型做結構化決策,不用生成模型去推理」聽起來是新東西,但這個模式其實已經在大廠的內部基礎設施裡跑了一段時間,只是沒有對外開放成產品。Anthropic 在官方工程部落格《How we contain Claude》裡明白寫道:
原文引用(anthropic.com/engineering/how-we-contain-claude)
"Tool calls route through proxies that enforce network and file policy and can inspect return values before they enter the model's context. The classifier that does the inspection can be a small, fast model; it doesn't need to be the one doing the reasoning."
這句話幾乎就是 Jev 的定位敘述:把「決策」跟「推理/生成」拆成兩個模型分工。Anthropic 用這套機制做 Claude Code auto mode 的指令審批(號稱攔截約 83% 的過度自主行為)與工具輸出檢查;Jev 則是把同樣的架構思路產品化,開放成一個外部任何人都能呼叫的通用 API。
| 項目 | Anthropic 內部 classifier | Jev |
|---|---|---|
| 存取方式 | 內部基礎設施,不對外開放 | 公開 API(早期 waitlist) |
| 用途範圍 | 窄(指令審批、工具輸出檢查等特定安全場景) | 通用(開發者自訂任意 Choice/Score/Noul 問題) |
| 輸出型態 | 多為二元判斷(允許/擋) | 三種結構化原語,含機率與 confidence |
| 資料流向 | 留在 Anthropic 自己的基礎設施內 | 流向 TypeSafe 控制的第三方 hosted API |
這個對照正是下一節資安分析的起點:同一種架構模式,換一個「誰控制這個決策節點」的答案,風險模型完全不同。
資安視角:Jev 是不是一種 Man-in-the-Middle?
從架構位置來看,答案是肯定的——不是貶義,是結構事實。Jev(跟 Anthropic 那個內部 classifier 一樣)坐在「輸入 → 決策 → 執行」的中間:它能看到你送進去的 state 資料,也能透過回傳的決策左右下游系統的行為。這正是 man-in-the-middle 的架構位置,只是意圖是防禦/輔助性的,而不是惡意攔截。
風險一:它自己變成新的攻擊面
只要 Jev 的判斷會左右下游動作(例如接進風控、越獄偵測、agent 決策流程),攻擊者的目標就會轉向 Jev 本身——用 prompt injection 或對抗性輸入去騙它給出錯誤的 Choice/Score/Noul,邏輯上跟繞過任何 gatekeeper 一樣,只是被攻擊的對象換成了一個「會給機率的分類器」。RLCD 訓練法宣稱能讓機率校準得更準,但校準過的機率不等於對抗攻擊免疫——這兩件事是不同的技術問題。
風險二:信任委外——資料真的會流經第三方
因為 Jev 目前只有 hosted API,沒有開源權重、不可自行部署,只要你用它,state 資料(可能是客戶對話、業務資料、內部系統狀態)就會真的流向一個你不完全控制的節點。這跟傳統 MITM 最相似的地方在於:這不是比喻,是字面意義上的資料流路徑。TypeSafe 的隱私政策明文表示不會拿 input 去訓練模型、也不會揭露給服務供應商以外的第三方(見下方 FAQ),但「政策承諾」跟「架構上資料是否流經第三方」是兩個不同層次的問題——前者是治理層的保證,後者是不可迴避的技術事實。
評估建議
如果考慮把 Jev(或任何 hosted decision classifier)接進含敏感資料的 pipeline,至少要確認三件事:(1) 傳入的 state 是否已先做過資料最小化/去識別化,不必要的敏感欄位不要送出去;(2) 這個決策節點若被騙出錯誤判斷,下游會造成什麼實際後果,是否有二次驗證機制;(3) 官方的資料使用政策與合約條款(Terms of Use/Privacy Policy/DPA)是否符合你的合規要求。
一個動作要送兩次 LLM 嗎?插入位置才是重點
不是每個動作都需要雙重送——通用生成模型跑一次、Jev 再跑一次。實務上 Jev 更常見的用法是卡在 pipeline 裡特定的決策節點,角色依插入順序而不同:
兩種模式的資安意涵不同:分流器模式下,Jev 只是決定「要不要」叫通用模型,本身不放行任何已經生成的動作,攻擊面相對有限;守門員模式下,Jev 直接掌握「放行或擋下」的權力,一旦被騙過就等於繞過了整道防線——這也是為什麼插入順序本身,就是資安分析要看的重點,不能只看「有沒有用 Jev」。
看待官方宣稱數字時的提醒
效能與成本宣稱尚待第三方驗證
TypeSafe 宣稱 Jev 比一般 LLM 便宜數百倍(官方比較基準約 238 倍起,部分報導引用到 445 倍),但目前這些對比多為官方自行測試(self-tested),尚未看到獨立第三方基準測試覆核。官方自己也承認:「we can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing」——連他們自己都還無法排除現在的定價是靠融資補貼撐出來的可能性。評估導入前建議用自己的實際場景做基準測試,不要只憑官方數字下決策。
常見問題(更新日期:2026-09-18)
Jev 是免費的嗎?怎麼收費?
不是免費,屬於用量計費:input token 收費 $0.042/百萬 tokens,output(結構化決策結果)不額外收費。目前是早期 waitlist 存取,需申請 API key。來源:typesafe.ai/blog(更新 2026-09-18)。
Jev 怎麼開始用?
到 console.typesafe.ai/settings/keys 申請 early-access API key(也可透過 Vercel AI Gateway),安裝 SDK(Python:pip install typesafe-sdk;JS:npm install @typesafe-ai/sdk),呼叫 POST https://api.typesafe.ai/v1/systemone,傳入 1 個 state 加任意數量的 Choice / Score / Noul 問題即可拿到結構化決策。完整範例見本文「怎麼用」章節。
傳給 Jev 的資料會被拿去訓練模型嗎?
官方政策明文表示不會:TypeSafe 不會用使用者的 prompt/input 訓練或微調任何 AI/ML 模型,也不會把 input 揭露給服務供應商以外的第三方,不販售或用於跨情境行為廣告。來源:typesafe.ai/legal/privacy-policy(更新 2026-09-18)。
Jev 跟一般 LLM(如 GPT、Claude)有什麼不同?
一般 LLM 逐 token 生成自然語言文字,需要應用端再解析、驗證、必要時重試;Jev 屬於 TypeSafe 定義的「System One Model」,直接輸出型別化的結構化決策,不生成文字,設計上就是要跳過解析這一步。
Jev 可以自己部署(self-host)嗎?
目前不行。Jev 只透過 TypeSafe 的 hosted API 提供,沒有開源權重或可自行部署的版本——這也是本文討論資安風險時的重點之一:資料必然會流經 TypeSafe 控制的第三方節點。
結論
Jev 有趣的地方不在於它「發明」了什麼新技術——用小快模型做結構化決策,Anthropic 自己的工程部落格早就講過同一句話。真正值得注意的是它把一種原本藏在大廠內部基礎設施裡的架構模式,反向包裝成一個任何開發者都能買的外部 API。
這件事同時帶來效率跟風險:效率是顯而易見的(省下大模型推理成本、拿到校準過的機率、不用自己寫解析邏輯);風險則是這篇文章想強調的——只要你把決策權交給一個外部節點,不管它多快、多便宜,它在架構上就站在你的資料流中間。要不要用、放在 pipeline 的哪個位置、傳多少資料進去,都是需要提前想清楚的資安決策,不是接上 API 就結束了。
- 先確認:這個節點放行/擋下的權力有多大——分流器風險 < 守門員風險
- 傳入的 state 做過資料最小化,不必要的敏感欄位不要送出去
- 官方數字(尤其效能/成本比較)目前多為自測,導入前用自己場景覆核
- 確認官方資料使用政策符合自己的合規要求,而不是只看架構圖上「安全」兩個字